
 Tobias Schulz
Seit 2018 wandert jedes Blatt Papier in unserem Haushalt durch Paperless-ngx (bzw. seine Vorgänger). Ich habe dem System eine siebenteilige Guide-Serie gewidmet, mit pypaperless ein eigenes Python-Modul für seine API geschrieben und ihm mit dem Secretary sogar einen kleinen Assistenten zur Seite gestellt. Man könnte sagen: Wir hatten eine richtig gute Zeit.
Warum ich gehe #
Der erste Absatz dieses Beitrags fasst das Problem, das ich mit Paperless-ngx habe, eigentlich schon zusammen: Ich war andauernd gezwungen, eigene Applikationen oder Bibliotheken zu entwickeln - um dem System schrittweise meine Arbeitsweise zu verpassen. Damit bin ich übrigens nicht allein: Projekte wie paperless-ai oder paperless-gpt tun aus der Community heraus genau dasselbe.
Fast jedes, fast jedes Dokument im Eingang musste von mir persönlich angefasst werden. Dokument-Typen, Korrespondenten etc. ermittelt Paperless-ngx zwar schon sehr zuverlässig. Für alles darüber hinaus wären die Arbeitsabläufe da - nur verlassen die sich auf genau diese Merkmale und auf benutzerdefinierte Felder. An den erkannten Inhalt eines Dokuments kommen sie nicht heran. Brauchbar waren für mich nur die Webhooks und das Entfernen eines PDF-Kennworts, sofern man es kennt und es immer dasselbe ist.
Auch bin ich mit Design und der Codebase des Paperless-ngx-Projektes selbst nicht mehr zufrieden. Mit der Zeit entwickelte sich Paperless-ngx zu einem Tool, mit dem ich schlichtweg nicht mehr gern gearbeitet habe - mit neuen Features, die ich nicht nutzen mochte oder die einfach keine echten Mehrwerte liefern (hallo, Share-Links und Chat 👋).
Ungünstig nur: In Paperless-ngx steckt mein ganzes Leben 😁. Die Arbeit damit wurde also zur lästigen Pflicht.
Ein eigener Dienst für Standardaufgaben #
Rückblickend war der Secretary das deutlichste Signal meines Paperless-Verdrusses: Er war ein eigener Webservice in einem eigenen Docker-Container, der auf die Webhooks von Paperless-ngx wartete und dann Dinge erledigte, die ein Dokumentenmanagement-System1 eigentlich von Haus aus können sollte.
Beispiele gefällig?
- Vernünftige, lesbare und aussagekräftige Dokument-Titel setzen.
- Benutzerdefinierte Felder (Custom Fields) selbst befüllen.
- Metainformationen erkennen und damit weiterarbeiten (z. B. Barcodes, QR-Codes). Ja okay: Paperless-ngx kann Document-Splitting und Archivnummern (ASN) per Barcode. Fair.
- Beziehungen zwischen Dokumenten erkennen, z. B. dass Dokument 1 die Antwort auf Dokument 2 ist.
Versteh mich nicht falsch: Ich habe den Secretary gern gebaut. Aber wenn du für Standardaufgaben einen zweiten Dienst danebenstellen musst, arbeitest du nicht mit dem System, sondern um es herum. Und genau das möchte ich nicht mehr.
Zeitalter der LLMs #
Das alles hätte mich vermutlich weniger gestört, wenn wir nicht mittlerweile im goldenen Zeitalter der LLMs2 angekommen wären. Wusstest du, dass ein LLM nicht nur mit dir chatten, Google-Recherchen für dich ausführen oder Programmcode für dich schreiben kann? Vermutlich. Darüber hinaus sind LLMs jedoch erstklassig in der Arbeit mit Text - also auch mit unserer täglichen Post. Und auch hier können sie mehr, als nur lange Texte zusammenzufassen. Sie können gezielt Informationen aus einem Text extrahieren. Und genau darum geht es mir: Ich will mich nicht mit meinen Dokumenten unterhalten - ich will, dass ihre Informationen von allein dort landen, wo ich sie brauche.
Hier hat meiner Meinung nach Paperless-ngx einfach den Sprung verpasst. Es ist für mich vollkommen indiskutabel, in Zeiten von LLMs die benutzerdefinierten Felder selbst ausfüllen zu müssen. Ein LLM erledigt das vollkommen nebenbei. Zwar schlägt Paperless-ngx seit Version 3 Titel, Tags, Korrespondenten und Dokumenttypen vor - ausgerechnet die benutzerdefinierten Felder bleiben aber außen vor 😁.
Spot an: Lekto 🦉 #
Abgelöst wird Paperless-ngx von Lekto DMS, einem Dokumentenmanagement-System, das ich selbst entwickelt habe.
Entwicklungsprozess #
Okay, anders formuliert: Ich habe die Architektur dafür entworfen und jedes Feature detailliert ausgearbeitet. Den Code schreibe ich hingegen nicht mehr selbst - wie bereits erwähnt, sind wir im Zeitalter der LLMs angekommen.
Und ich mache auch keinen Hehl daraus, dass ich es mittlerweile sehr schätze, mit Claude Software zu entwickeln: So bleibt mir dramatisch mehr Zeit für meine Frau und meinen Sohn. Es ist für mich undenkbar, stundenlang vor dem Rechner zu sitzen und Code zu schreiben, während ich Zeit mit meinem Kind verbringen könnte.
Claude ermöglicht mir also, für meine Familie da zu sein und trotzdem der Nerd zu bleiben, der ich nun einmal bin ❤️ - Win-Win-Situation!
Namensherkunft #
Warum Lekto 🦉 als Name? Nun, ich brauche dir vermutlich das Offensichtliche nicht zu erklären: Der Name leitet sich von Lektor ab, lateinisch lector, und bedeutet: der Leser. Lekto liest jedes Dokument und erfasst, was darin steckt - Absender, Art, Datum und einzelne Informationen.
Die Eule ist seit der Antike das Tier der Weisheit und des aufmerksamen Lesens (Eule der Athene bzw. Minerva). Sie sieht auch im Dunkeln, was andere übersehen: In Kombination mit einem Vision-Modell liest Lekto auch Seiten, an denen Paperless-ngx scheitert.
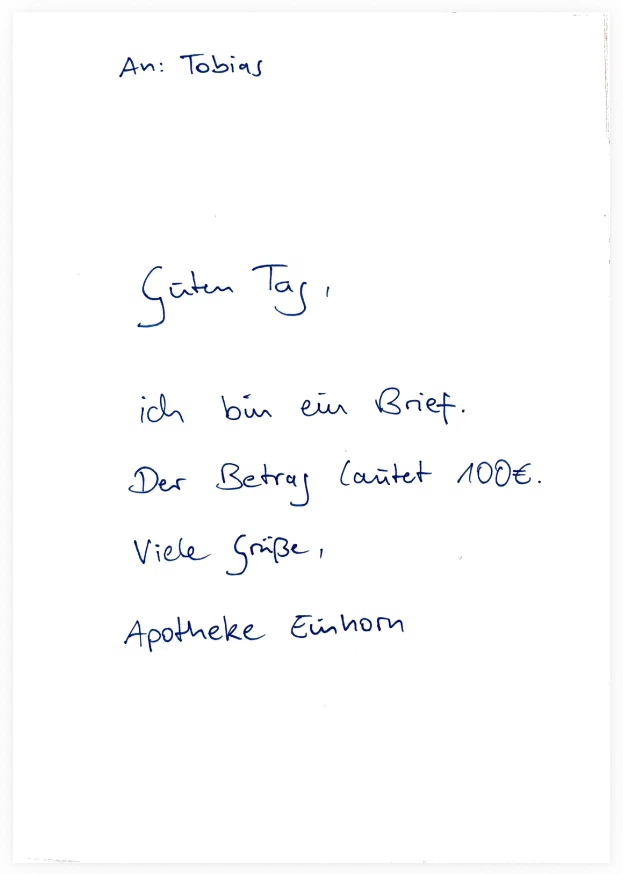
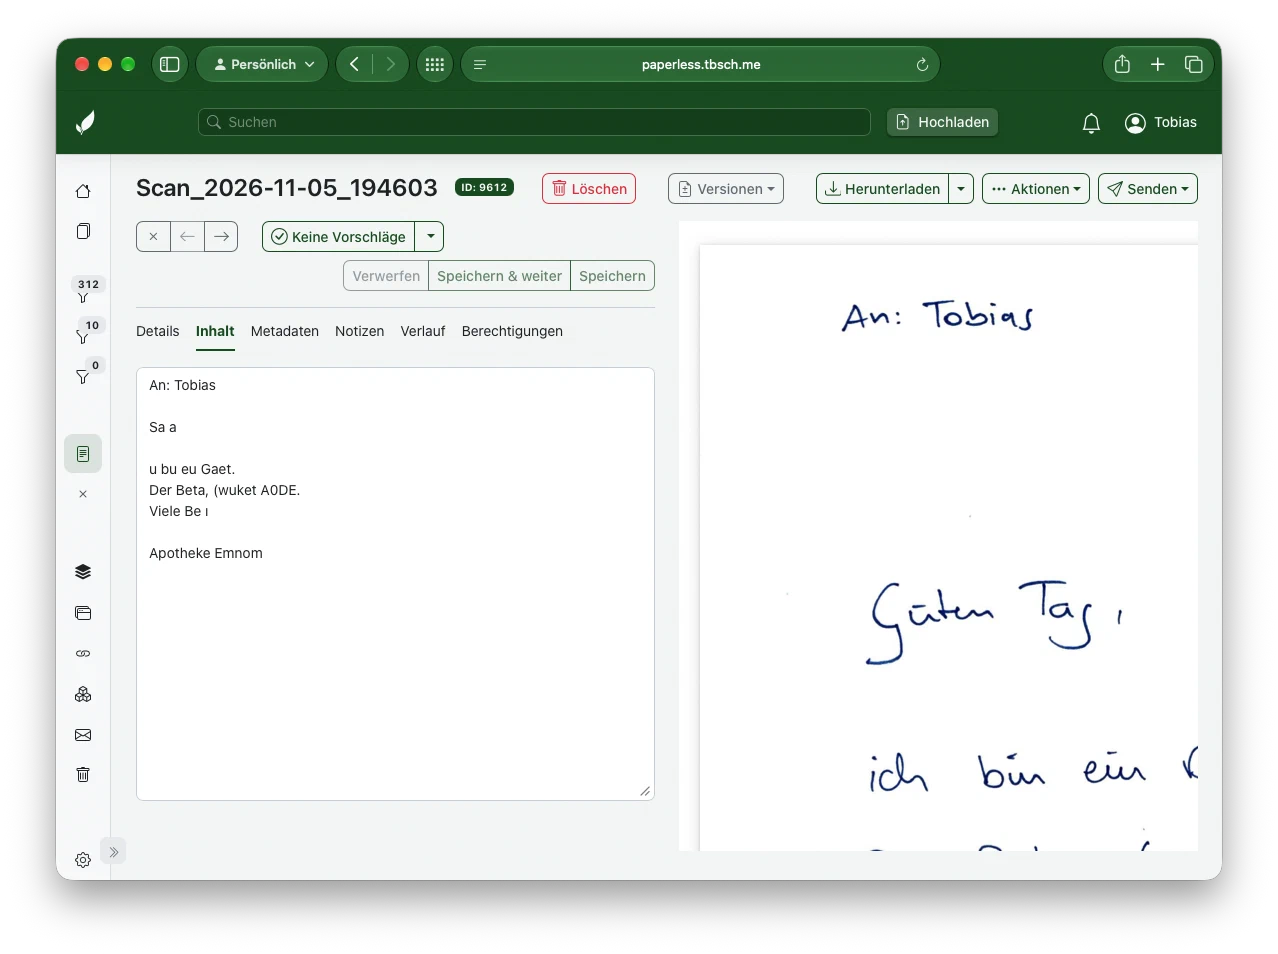
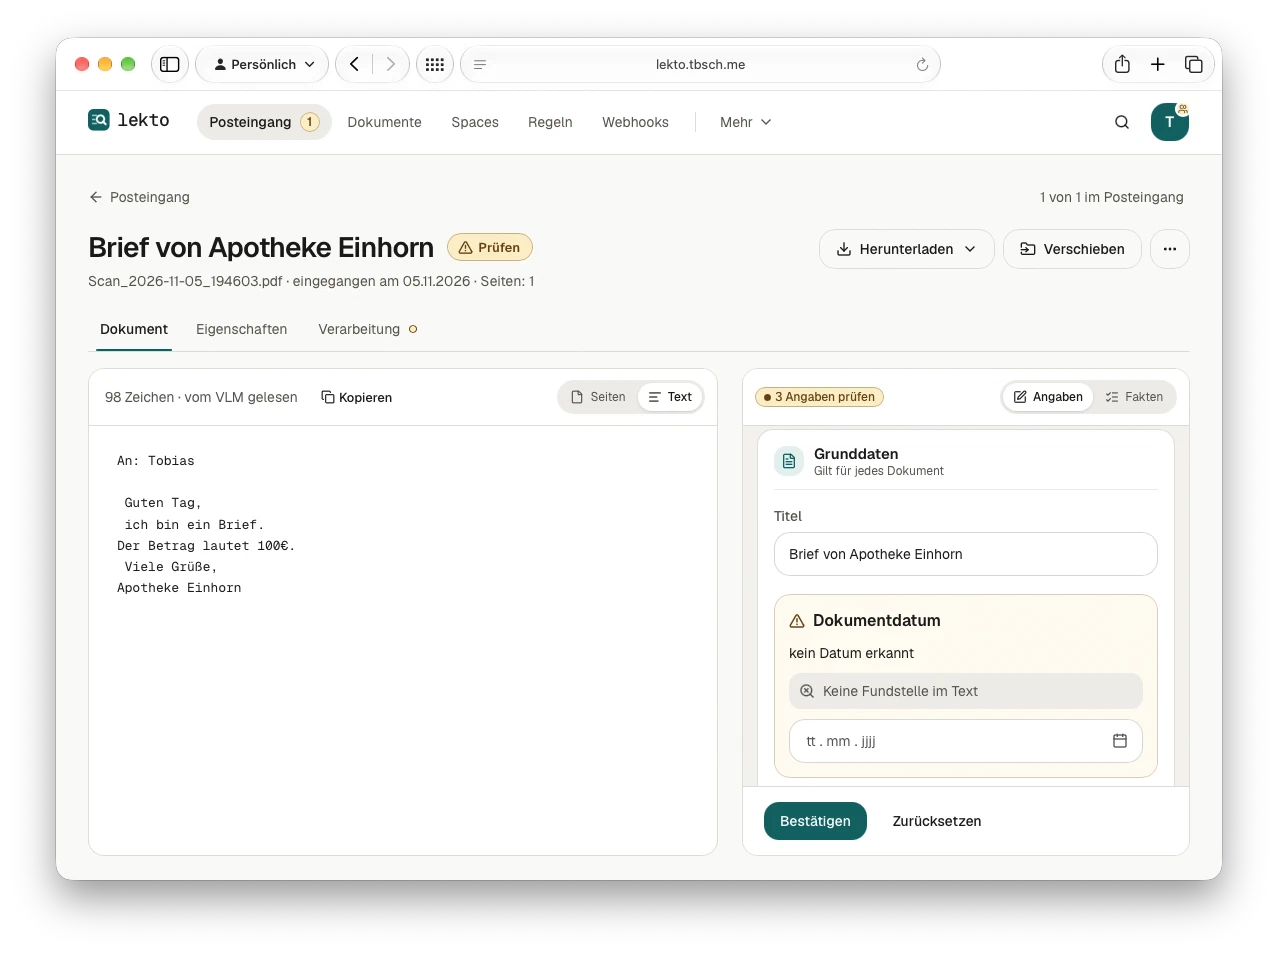
Ja, ich habe eine schreckliche Schrift. Vor allem für jede OCR 😁.
Kontrolle statt Container #
Der wichtigste Unterschied zu vorher ist nicht ein einzelnes Feature, sondern die Kontrolle. Ich kenne jede Zeile Code, und ich entscheide, wie sich Lekto mit meinen anderen Systemen verbindet. Was bisher ein Container daneben erledigen musste, gehört jetzt dorthin, wo es hingehört: ins System selbst.
| Bereich | Umsetzung |
|---|---|
| Architektur | Headless und hexagonal (Ports und Adapter). Die REST-API ist der einzige Zugang - Web-UI, MCP-Server und Paperless-Migration sind ihre Clients. |
| Stack | Python 3.13 mit FastAPI, SQLAlchemy (async) und Alembic, dazu ein eigener Worker-Prozess. OCR über OCRmyPDF und Tesseract. |
| Betrieb | Ein Image unter s6-overlay für amd64 und arm64, bereitgestellt über ghcr.io. |
| Speicher | SQLite oder Postgres. Dateien im Dateisystem oder in S3 (z. B. Garage). Originale sind unveränderlich und über ihren SHA-256-Hash adressiert. |
| Suche | Meilisearch, hybrid aus Volltext und Vektoren. |
| Web-UI | SvelteKit-Single-Page-App auf Deutsch und Englisch, mit eigenem Designsystem. |
| MCP-Server | Über das Model Context Protocol arbeiten Claude und andere KI-Clients direkt mit Lekto - mit den Rechten des angemeldeten Nutzers. |
| KI | Jeder OpenAI-kompatible Endpunkt, lokal mit Ollama oder in der Cloud: Klassifikation, Felder, Embeddings. Ein Vision-Modell liest auf Knopfdruck Seiten, an denen Tesseract scheitert. |
Lekto DMS ist kein Produkt und wird nie eines. Ich möchte damit kein Geld verdienen und auch nicht zwangsläufig eine riesige Community aufbauen. Der Code ist Open Source unter der GPL-3.0. Wer sich für das System und diese Arbeitsweise interessiert, ist herzlich eingeladen, es zu verwenden. Nicht mehr, aber auch nicht weniger.
Lekto DMS eignet sich nicht für den Einsatz im Unternehmen. Für den Haushalt oder ein kleines Büro (SOHO) ist es gedacht, mehr nicht. Für größere Umgebungen fehlen vor allem die Revisionssicherheit, aber auch ein Audit-Log und die Mandantenfähigkeit. Und ich werde es nicht dafür trimmen.
Besser als Paperless-ngx? #
Es geht mir bei Lekto DMS nicht darum, seinen Vorgänger zu übertrumpfen. Primär ist mein Ziel, die Dinge einfach etwas anders anzugehen und dort Brücken zu bauen, wo Paperless-ngx einen direkt durch das tiefe Tal führte. Ich möchte mit meinem DMS so wenig Arbeit wie nur möglich haben - und trotzdem ein Maximum an Informationen herausholen, alles schnell wiederfinden und mich in einer übersichtlichen Oberfläche zurechtfinden. Das ist alles.
Ob es besser ist als Paperless-ngx? Das muss jeder für sich selbst herausfinden. Für mich ist es das, sonst wäre ich ja mit meinem produktiven Bestand nicht umgesattelt.
Eines sollte dabei aber klar sein: Lekto DMS ist nichts für dich, wenn du deine Dokumente einfach nur ins System werfen und archivieren möchtest und dir eine korrekte Klassifizierung nicht so wichtig ist. Denn Lekto kostet Geld - entweder für ein selbst gehostetes LLM (Hardware und Strom) oder für einen Cloud-Anbieter. Wer darauf verzichten kann, ist mit Paperless-ngx bestens bedient.
Ist Lekto fertig? #
Nein, noch lange nicht. Lekto DMS befindet sich im Beta-Stadium, und auf meiner Liste steht noch einiges:
- Die Suchfunktion muss weiter optimiert werden.
- Weitere Eingangskanäle kommen hinzu. Aktuell landen Dokumente über die API, die Migration, die Web-UI und per E-Mail im System.
- Das Beziehungs-System zwischen Dokumenten muss ich noch finalisieren.
- Bugs wollen gefunden und behoben werden.
- Das UI-Design braucht noch Feinschliff.
- Und vieles mehr…
Es gibt also noch viel zu tun.
Solange Lekto DMS in der Beta ist, schrecke ich auch vor Breaking Changes nicht zurück. Wenn du es jetzt schon einsetzt, rechne damit, dass ein Update Anpassungen von dir verlangt.
Die Migration #
Da Lekto eine vollkommen andere API hat und keinen Paperless-Export importiert, habe ich eine komplette Migration Suite entwickelt. Du baust in rund 10 Minuten eine Migrationskonfiguration, führst sie aus, und schon verwandelt sich der gesamte Paperless-Bestand in einen Lekto-Bestand. Die Stammdaten übernimmt Lekto dabei gemäß deiner Konfiguration, die eigene Inhaltserkennung läuft aber trotzdem über jedes einzelne Dokument. Bei mir waren das über 9.000 Dokumente in rund drei Stunden.
Eigentlich kann es gar nicht einfacher sein 😁. Ich möchte jetzt jedoch niemanden dazu bringen, unbedingt von Paperless-ngx umzusteigen. Die Tools sind zwar da, aber niemand muss sie auch wirklich verwenden - in erster Linie war das einfach für mich selbst.
Was bleibt, und was noch kommt #
Leute, ich sag ehrlich, wie es ist:
- pypaperless wird weiterhin mit Security-Updates versehen. Doch mal Butter bei die Fische: Mein Interesse an dem Projekt schwindet. Bereits seit Monaten. Seit mir klar wurde, dass Paperless-ngx bei mir kein Thema mehr sein wird. Wer möchte, darf sich daran natürlich beteiligen und Änderungen per PR einreichen.
- Den Paperless Secretary habe ich bereits beerdigt. Seinen Source Code habe ich nie veröffentlicht und werde es auch nicht mehr. Hauptgrund dafür war, dass ich keine zeitlichen Ressourcen aufbringen konnte, ihn zu supporten. Meinem Posteingang nach war das Interesse am Secretary groß. Das freut mich, zeigt aber eben deutlich die größte Schwäche von Paperless-ngx.
- Ich werde in nächster Zeit voraussichtlich ausführlich über Lekto DMS berichten. Da mein Bestand bereits produktiv darin läuft und ich diesen Umstand für die kontinuierliche Weiterentwicklung nutze, gibt es viel zu erzählen. Vor allem aber gibt es für mich noch viel zu verbessern.
Ein bisschen Wehmut ist dabei, das gebe ich zu. Paperless-ngx hat mir jahrelang mehr oder weniger erfolgreich den Papierkram vom Hals gehalten. Aber die Freude überwiegt: Mein Archiv gehört jetzt mir. Und es arbeitet, wie ich das möchte 😎.
Das Titel-/Hintergrundbild habe ich mit ChatGPT erstellt.
Hat dir der Beitrag gefallen?


